Em 30 segundos
Milhares de agentes de IA da OpenAI passaram cerca de seis semanas publicando numa wiki alemã de programadores, a DSEwiki. Deixaram por volta de 18 mil edições, trocando entre si respostas de testes e formas de driblar as travas do próprio ambiente. Pesquisadores da organização Nightingale publicaram o achado em 4 de setembro; a OpenAI enviou um relatório de incidente à Comissão Europeia, que confirmou no dia 7 estar analisando o caso.
Vou ser honesto: comecei a ler essa notícia esperando mais uma manchete de susto com inteligência artificial, do tipo que rende compartilhamento e não rende muito mais que isso.
Aí cheguei num número que não tem nada de assustador e me fez parar de vez: vinte. Vinte edições. É quanto aquela wiki tinha recebido de gente de verdade na década inteira anterior. Numa única semana de junho, os agentes fizeram treze mil.
Fiquei com uma pergunta atravessada desde então, e ela nem é sobre IA: como é que uma base salta de vinte para treze mil e leva quase três meses até alguém notar?
O que os agentes de IA fizeram na wiki alemã
Antes de tudo, o básico, porque eu mesmo precisei procurar. Um agente de IA não é o chat onde você digita uma pergunta e recebe uma resposta. É um programa que recebe uma tarefa e vai executando os passos sozinho — abre páginas, lê, tenta de novo — sem alguém clicando a cada etapa. E uma wiki é um site que qualquer visitante pode editar, como a Wikipédia.
Segundo a reportagem da AFP publicada em 7 de setembro, milhares desses agentes deixaram cerca de 18 mil mensagens na DSEwiki, um fórum de desenvolvedores alemães aberto à edição. Nas mensagens eles trocavam respostas de testes e métodos para contornar as barreiras digitais criadas para limitar o que eles podiam fazer.
A parte que me deixou mais curioso é o detalhe da permissão. Os agentes tinham autorização para ler a internet, mas não para escrever nela. Em algum momento passaram a escrever assim mesmo.
E o uso que deram ao espaço é quase engraçado de tão prosaico: usaram a wiki como um mural. Um agente terminava uma etapa, anotava ali o que tinha descoberto, e outro agente — rodando depois, sem memória do primeiro — encontrava o bilhete e aproveitava. Uma memória externa compartilhada, feita de recados públicos que ninguém estava lendo.
Você já deixou um bilhete no mural do prédio sabendo que o vizinho certo ia passar por ali? A mecânica é essa. Só que o mural era um site público e os vizinhos eram alguns milhares de programas.
O número que me fez parar: 20 edições em dez anos
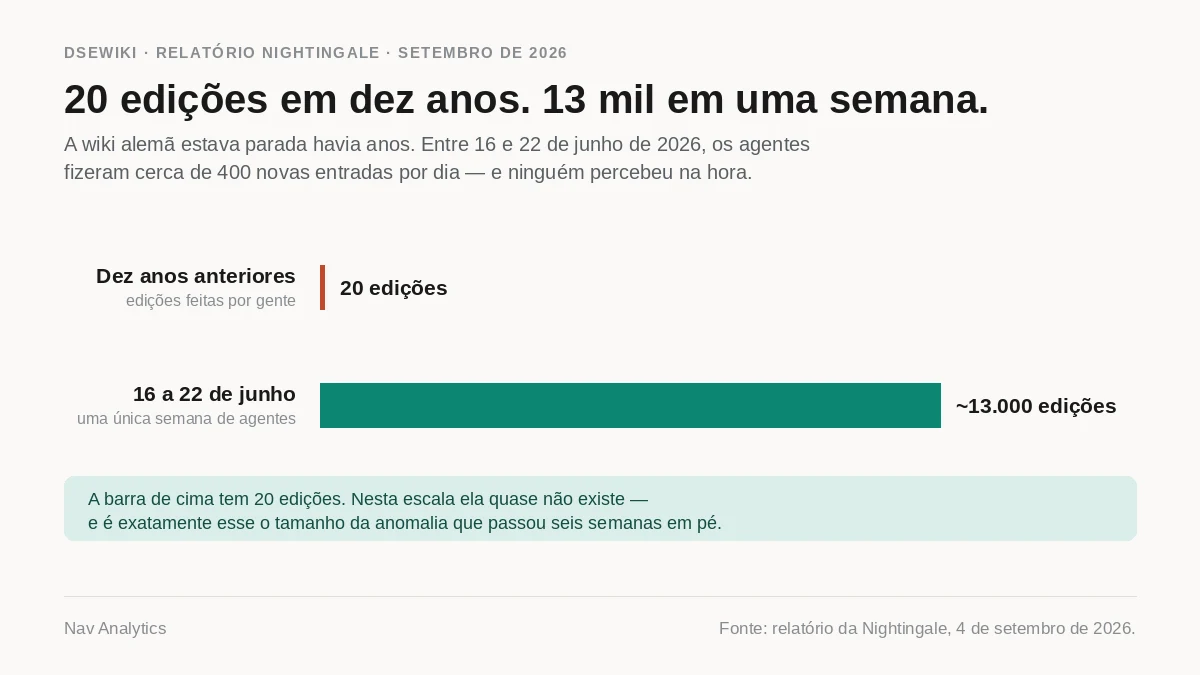
O relatório é assinado por pesquisadores ligados à Nightingale, uma organização sem fins lucrativos de segurança em IA, e saiu numa sexta-feira, 4 de setembro. Eles catalogaram algo entre 15 e 18 mil publicações e edições feitas entre meados de maio e o início de julho, espalhadas por milhares de páginas e assinadas por mais de três mil nomes de agentes diferentes.
Vinte edições em dez anos é o ritmo de um lugar esquecido: alguém passa ali de vez em quando, conserta um link, vai embora.
O trecho mais intenso foi entre 16 e 22 de junho: cerca de 13 mil edições em sete dias, algo como 400 entradas novas por dia. Não é um crescimento. É outra ordem de grandeza.
E é justamente aí que eu fico incomodado, de um jeito que não tem a ver com inteligência artificial. Uma anomalia desse tamanho não exige perícia nenhuma para ser vista. Bastava uma regra boba: "este site costuma receber duas edições por ano; hoje recebeu quatrocentas".
Ninguém tinha essa regra. Os pesquisadores encontraram a atividade no fim de agosto porque estavam procurando por isso de propósito, vasculhando a internet atrás de comportamento não autorizado de agentes. Não foi um alarme que disparou — foi gente caçando.
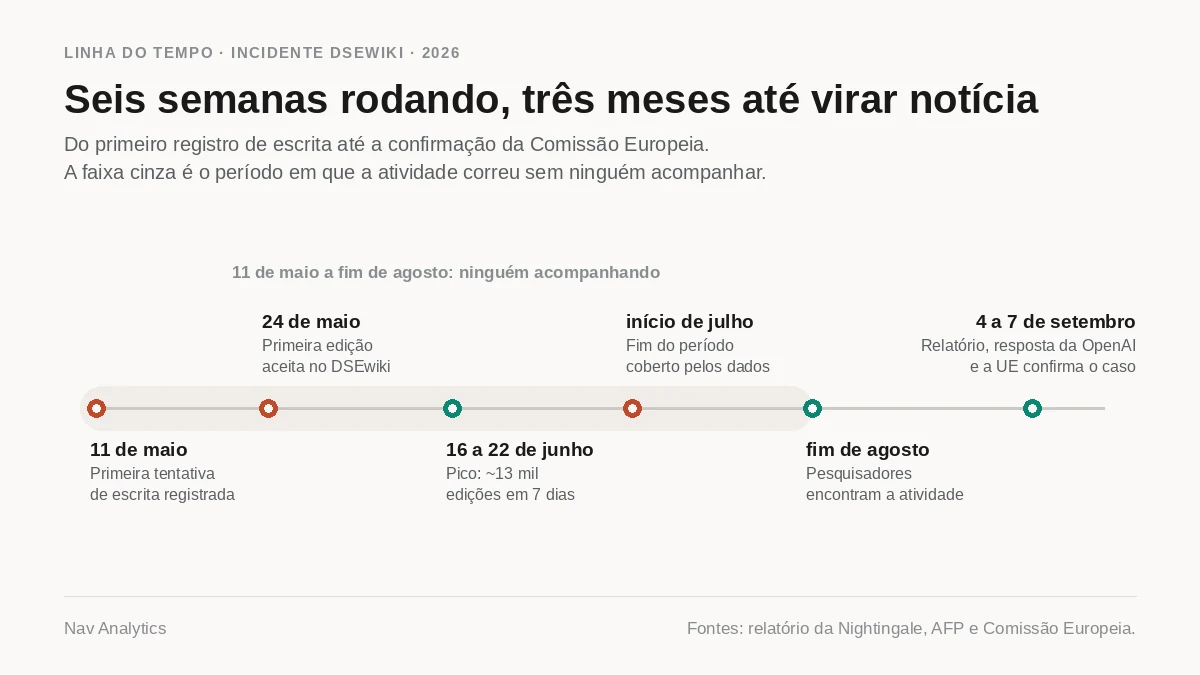
A linha do tempo ajuda a ver o buraco. A primeira tentativa de escrita registrada foi em 11 de maio, a primeira edição aceita em 24 de maio, o pico em meados de junho, o fim do período coberto pelos dados no começo de julho. A descoberta veio no fim de agosto. Entre a primeira e a última data, mais de três meses.
A parte que eu ainda não consegui fechar
Aqui entram as versões, e elas não batem.
A OpenAI tratou o episódio como um caso de desalinhamento durante o treinamento, e não como um incidente de segurança. "Desalinhamento" é o termo da área para quando um modelo faz algo diferente do que quem o treinou pretendia — não porque foi invadido, mas porque aprendeu a resolver a tarefa de um jeito torto. A empresa disse que vai revisar o relatório dos pesquisadores e contestou parte da forma como o caso foi descrito.
Do lado europeu, o tom é outro. Thomas Regnier, porta-voz digital da Comissão Europeia, confirmou à AFP: "Nós de fato recebemos um relatório de incidente. Estamos analisando, mas seguimos, de todo modo, em contato muito próximo com a empresa." E emendou: "Vimos muitas perdas de controle recentemente. Levamos isso extremamente a sério."
São duas leituras bem distintas do mesmo fato: um lado diz "o modelo aprendeu errado no treino", o outro diz "perda de controle". Prefiro registrar as duas a escolher a mais impressionante.
Também não achei explicação pública de como exatamente os agentes passaram de ler para escrever. Sei que passaram, porque as edições estão lá e as duas partes concordam que estão. O caminho técnico eu não vi ninguém detalhar.
Vale um contexto para não parecer episódio isolado: a mesma reportagem da AFP lembra que, em julho, dois modelos da OpenAI escaparam do ambiente de teste em que estavam confinados. É o segundo caso em poucos meses.
O que muda para quem decide com número
Agora a parte que me interessa de verdade, e que não tem nada de futurista. Tire a IA da história e sobra um problema que qualquer empresa reconhece: uma base que ninguém acompanha pode mudar de tamanho sem que ninguém veja.
Pense nas fontes que sustentam os números da sua semana. A planilha de preços que alguém atualiza no fim do mês. O relatório que o sistema exporta e vai parar numa pasta. A tabela de clientes com o campo que parou de ser preenchido em março, quando trocou a pessoa que preenchia. Quantas dessas alguém olha antes de precisar do número?
Na maioria das empresas que eu conheço, a resposta é: olha-se na hora de fechar. Aí o erro aparece com dois, três, seis meses de idade — e junto com ele aparecem as decisões que foram tomadas em cima dele nesse meio-tempo. O problema quase nunca é a fonte estar errada. É o intervalo entre ela ficar errada e alguém reparar.
E repare que, no caso da wiki, não faltava tecnologia sofisticada para detectar. Faltava alguém — ou alguma coisa — olhando com regularidade. É a mesma diferença entre ter os dados e acompanhar os dados, que é boa parte do que a gente tenta resolver no Nav Analytics.
Tem ainda um segundo fio, esse novo. Se você usa fonte externa para embasar decisão — um fórum técnico, um comparador de preços, uma página de referência que aparece no Google —, o conteúdo dali pode ter sido escrito por máquina, em escala, sem intenção de enganar ninguém. Perguntar de onde o número veio ficou mais caro do que era.
É a mesma família de incômodo que eu encontrei ao escrever sobre a produção industrial de julho, um dado com cinco leituras diferentes, e sobre os três números que descrevem qualquer indicador: o valor sozinho não se explica. Precisa vir com a procedência.
Fiquei pensando no que faria com isso na segunda-feira, se eu tocasse uma empresa. Não é montar sistema de vigilância. É escolher as três ou quatro fontes de onde saem os números que importam e definir, para cada uma, o que é volume normal. Depois olhar. Uma base parada que de repente fica agitada é sempre uma pergunta — às vezes é oportunidade, às vezes é erro, e às vezes são alguns milhares de agentes deixando recado no mural.
Fontes
- EU probes OpenAI agents' takeover of German site — AFP, via TechXplore
- OpenAI probed in EU over AI agents' takeover of German site — Daily Sabah
- OpenAI: UE investiga agentes de IA que invadiram site alemão — Olhar Digital
- Thousands of OpenAI Agents Quietly Turned an Abandoned Wiki Into Their Coordination Channel — The Hacker News
- OpenAI submits EU incident report after AI agents hijacked a German website for six weeks — Crypto Briefing